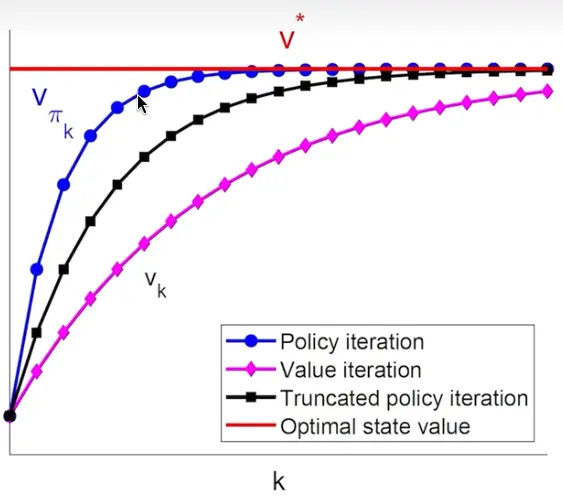
| 方法 | 策略评估 | 策略改进 | 特点 |
|---|
| 值迭代 | 单步更新 | 隐式改进 | 计算效率高 |
| 策略迭代 | 精确求解 | 贪婪改进 | 每轮改进保证 |
| 截断策略迭代 | 有限步迭代 | 贪婪改进 | 灵活平衡 |
k∗1 次迭代:
- Policy update (1): πk+1=argπmax(rπ+γPπvk)
- Value update: vk+1=rπk+1+γPπk+1vk
k∗∞ 次迭代:
- Policy evaluation (∞): vπk(j+1)=rπk+γPπkvπk(j),j=0,1,2,…
- Policy improvement: πk+1=argπmax(rπ+γPπvπk)
广义策略迭代 (Generalized Policy Iteration):
- 不求精确解, 只迭代有限 j 步
- 值迭代和策略迭代是特例